 外行人看个科普,内行人就当个乐子。今天作为写文章、小说的把平时琢磨的AI知识分享一下,聊聊,为什么说大模型看不懂长篇小说。
聊这个问题是因为,我有很多作者朋友都经常做这么一件事情:把一本几十万字百万字的小说或者名著,直接塞给AI,然后让他拆解书籍,回答问题。
但是,大模型真能看得懂那么长的书吗?
绝大多数情况下,答案是不能。
或者说,除非你花钱买了很复杂的工作流,否则是不可能的,那种直接打开豆包、DeepSeek、gemini的网页版,给他上传一个附件就像指望AI完全看明白一本书,是做不到的。
为什么?容我道来。
这篇文章,正好写在DeepSeek和Kimi都刚刚发布过提高大模型的上下文记忆能力的相关论文的节点,Claude、GPT、小米的新出模型也都开放了1M上下文长度,大模型卷到2026年,最近各大厂商都在疯狂宣传和跟进百万级别的token 上下文窗口,好像只要上下文窗口够大,AI 就一下子能干更多的事情了。
这个说法,对于编程,以及很多场景是说得通的,但是对于写作、阅读长文的场景,就不一定了。
对于写东西的人来说,很容易把上下文长当做一种利好,因为一个模型能装进1M的上下文,意思不就是模型一口气吃下一百万字的书吗?意思不就是就能理解整部小说、帮你写长篇小说了吗?
以前我给Deepseek发十万字它就不让了,以后我可以发五十万字了!这不厉害吗?它能看几十万字的小说了啊!
冷水我直接泼上去。并不能。
先不说AI所谓的Token和汉字不是一个折算的概念,对很多模型来说,比如claude,一百万token相当于是75万字左右汉字,并不是1:1。就算一百万上下文等于一百万字,这和模型真的能看懂一百万、记住一百万也毫无关联。
上下文窗口能容纳≠能理解
很多人把【上下文窗口】和【理解能力】混为一谈,这是最大的误区。
上下文窗口的长度其实一直和真实理解能力之间,隔着一道巨大的鸿沟。而和小说理解和写作这方面的能力又隔了一整个马里亚纳海沟。
上下文窗口的长度的意思,说白了就是告诉你模型理论上能接收多少文本输入。这就像一个人的视野范围——你能看到一百米外的东西,不代表你能看清那里的细节,更不代表你理解那里正在发生什么。能看见和看得懂,完全是两码事。
而我们读书人、看书人期待的AI的理解能力是什么?
是模型能不能在这个窗口内精确定位特定信息,能不能保持注意力不在长距离上变差,能不能理解我们聊天提到的语义而不是只记住一些符号,能不能建立跨文本的关联,能不能综合推理形成整体性的认知。
这些才是所谓人类对书籍、对文章的「理解」概念。
而一个模型可以声称它支持 100 万 token 的上下文,并不意味着它能在这 100 万 token 中做任何有意义的事情。
其实平时用AI查资料、提问题甚至拆书拆的比较多的朋友应该也早就都多少有所发现,目前的大模型根本做不到真正理解超长小说,更别说在超长上下文下写好小说。
一旦你聊天聊的长一点、久一点,模型就会前言不搭后语。
而很多把长篇小说塞进大模型让他总结的朋友也会发现,怎么中间的章节是胡扯的,根本没发生过?
这太正常了。因为大模型根本就没法做到那种程度。
它的上下文窗口只是「吃下了」那么长的书,但是没有消化,直接「拉稀」拉出去了。
想解决这个毛病,让大模型看懂长篇小说,目前唯一的解决方式是,要么你把书拆成碎片,一段一段看,一段一段理解,比如三万字一部分,分别喂给AI
要么,你就得上更复杂的 Agent 机制和工程设计,比如 ClaudeCode 为代表的 Agent 工作流目前就可以做到长篇的理解(我平时自己的工作流就是用ClaudeCode)
又或者,有一些专门给长篇设计的AI写作、拆书软件,其实也是在用Agent工作流,或者是把书拆分开,然后再组合的方式。当然那种就会更烧钱,烧时间。
总之,你如果不上「手段」,想在网页上简单和大模型聊天,传个长篇小说的txt附件,单次对话就问清楚关于这本书的一切?
做不到。
打个比方,假如说你把一整套《诛仙》塞给网页上的豆包,你问它张小凡和碧瑶的关系到底是怎么发展的。
它有极大可能性做什么?它会直接从网上去搜一个结论,或者根据模型训练过的内置语料给你一个答案。(因为诛仙太有名了,你不给它小说它也知道)
但假如,你问的是一本没有人在网上发布过,也没有读后感存在过的小众小说,AI就会立刻露馅了——因为它根本没有仔细把这本书看清楚过。
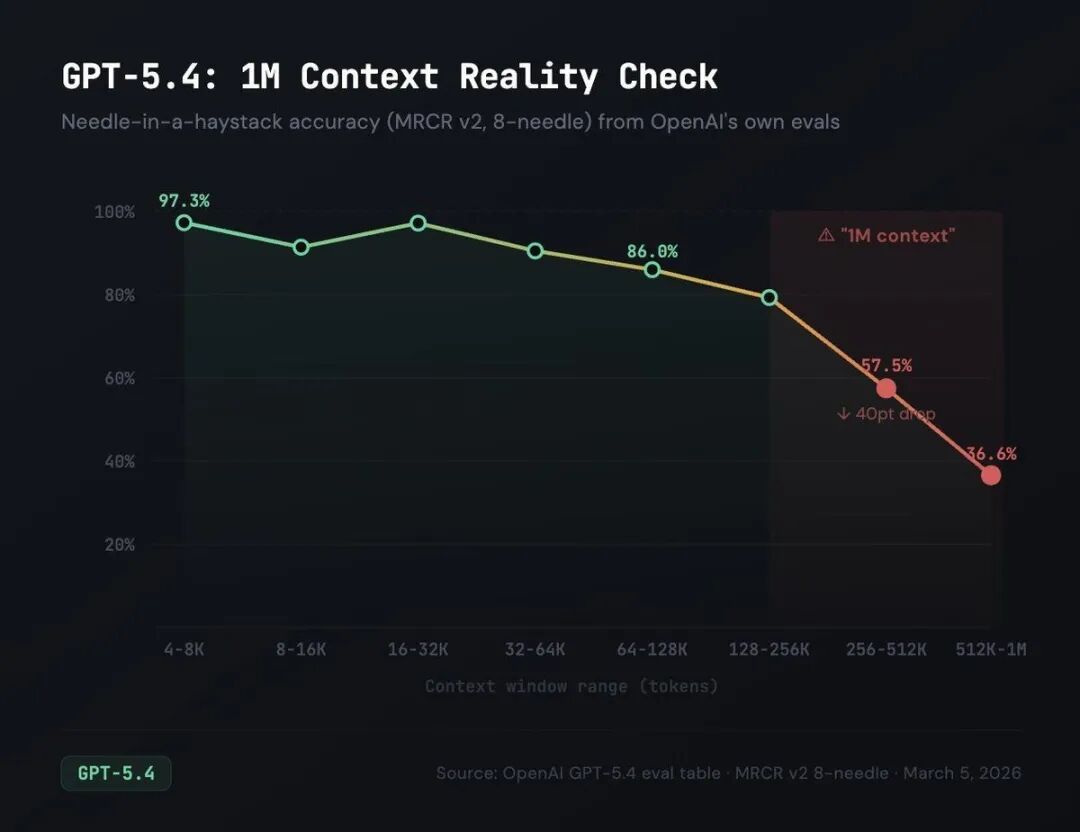 (最新的GPT-5.4旗舰模型,一旦离开256k的上下文长度之后,模型MRCR成绩也是直线下跌,到了百万token时,几乎不可用)
既然AI看不了长篇小说,那些所谓的大模型【长上下文能力】到底在测什么?
说到这里,很多人就说了,既然你说大模型看不了长文,那么现在每次新的模型出来,就会宣传自己的长上下文能力有多么强,记忆力多么厉害,这是怎么回事?难道他们的评测都是骗人的吗?
你说对了,还真不是,这些模型的上下文和记忆能力都是真实的,可问题在于,他们评测的能力和我们所以为的能力不是一回事。
先说说 MRCR-V2 8-Needle 这个非常流行的【大海捞针】记忆测试。
现在主流的长上下文能力测试之一叫 MRCR(Multi-Round Coreference Resolution,可以发直译为多轮共指消解),最新的常用版本之一是 MRCR-V2 8-Needle。听起来很高大上,但这类测试如果用形象的比喻的话,其实就是大海捞针。
怎么个捞法呢?
想象一下,有人给你一个巨大的图书馆,里面塞满了成千上万本书(大部分都是干扰用的),然后在里面藏了 8 张便签纸(这就是needles、被捞的针)。
每张便签上写着一首诗或者一篇短文,而且这些便签的主题还故意弄得很像——比如都是关于动物的诗,但分别写的是企鹅、鹅、夜鹭什么的。然后看模型能不能把这些鸟类区分出来。
具体的测试操作好比说是这样的:输入一段超长的多轮对话(可以达到百万 token),里面穿插了 8 个目标写作任务。比如
【写一首关于企鹅的公众号文章】、【写一篇关于夜鹭的博客】。
这些任务在格式或主题上高度相似,形成所谓的「对抗性混淆」,模型不仅要找到正确的主题,还要区分是第几次出现。
评分方式就是把模型输出和正确答案做字符串相似度比较,得分 0 到 1 之间。难度从 2-needle 到 4-needle 再到 8-needle 逐级递增,上下文长度也从短到长,最高能到 1M token。
那么最新的测试结果怎么样呢?拿目前公开数据中表现最好的 Claude 来说:
Claude Opus 4.6 在 1M context 下,256K 位置能拿到 91.9%,但到了 1M 位置就掉到 78.3%(有的报告说是 76%)。Claude Sonnet 4.6 稍微差一点,256K 位置 90.6%,1M 位置 65.1%。
这些数字看起来还行?问题来了,这只是最基础的能力测试而已。离读懂小说的要求还差得远。
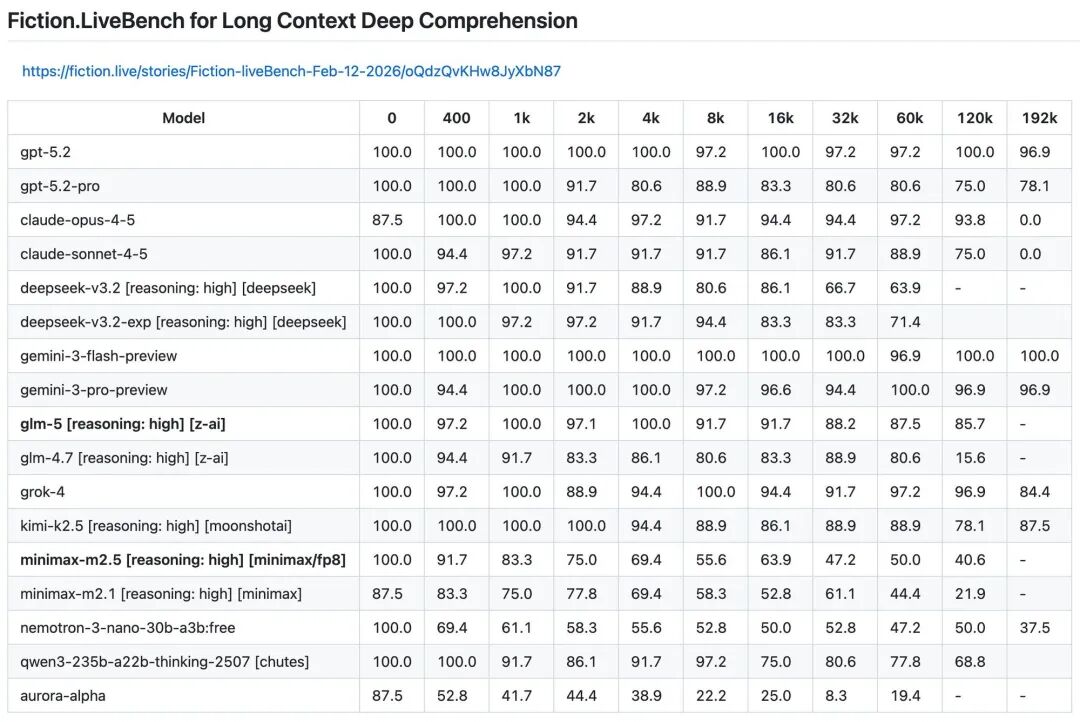 (fiction livebench评测:上一代主流模型的200k内上下文理解能力,国产模型都很不乐观,而有些实际上下文记忆很差的模型成绩也很好,更说明了评测对于真实小说理解的参考价值很低)
大海捞针测试的局限性在哪里?
说得直白点,MRCR 测的是大模型做「图书馆管理员」的能力,不是做「读者」或者「作者」的能力。
一个优秀的图书馆管理员能在百万册藏书中精确找到你要的那一本,但这不意味着他理解那本书的主旨,更不代表他有本事写那么长的书。
MRCR 测试的就是这种管理员式能力:精确检索能力(在海量文本中定位特定信息片段)、共指消解能力(区分「同类但不同」的多个目标,比如第 1 首 vs 第 2 首,企鹅 vs 鹅)、位置记忆能力(理解第几次这种序数关系)。
它测的是模型的注意力精度和信息定位能力,而不是理解力。模型只关心「能不能找到并原样复述那段文本」,不关心「是否理解了那段文本在说什么」。
对AI的小说阅读理解来说,这代表什么呢?
所以,问题关键就在于上边说的这种大海捞针的近似检索能力对于小说长文本的理解来说,只是最最基础的能力!
它甚至连AI 对小说长文的真实注意力都反应不了,只能在一定程度上作为【能否保持注意力】的一个浅显指标。
除了 MRCR,还有一些第三方开发者设计的上下文测试,比如 Fiction.LiveBench。这个项目顾名思义,稍微偏向于小说的真实场景,主要针对一部小说中的多点事实进行提问,需要 AI 具备简单的理解和推理能力。
听起来不错,是吧?毕竟稍微接近小说的实际情况一些了。
它的测试实际就是比 MRCR 复杂了一点:MRCR 是「定位→区分→原样复述」,而 Fiction.LiveBench 是「定位→提取→局部推理→产出答案」。
多了一步「局部推理」——你不能只是原封不动地复述,你需要基于定位到的信息做一些逻辑操作,比如「张三为什么在这一章突然崩溃了?」或者「张三的崩溃和李四昨晚偷偷去蹦迪两件事之间是什么关系?(答案是李四是张三的老婆,李四可能出轨了)」
简单的说呢,就是不仅让AI能找到答案,还能稍微把俩答案结合一下,推理出一个答案。
但是,这依然不能算特别的复杂,因为就只是多了那么一步而已。
但即使面对这个「不那么复杂」的测试,我看最新的测试,也只有最顶级的模型能在 200K 之内的上下文跨度下取得较好成绩(80% 到 90% 以上),比如GPT-5.2、Claude-4.5-opus,Gemini 3 pro。
是的,Gemini 3 Pro这个成绩居然非常的好。
一般人可能不知道我为什么强调这一点,但是用这个模型写过文,做过RP扮演的人应该知道我在说什么,G3pro可是在写小说,玩rp的很多人口碑里出了名的优化差、不稳定、长对话注意力差、忘性极高。
这么一个模型,怎么在这个测试里表现的还很完美呢?
但是这个评测的测试集是公开的,不会作假,那么只能说明一个问题,即使是评测要求已经很高的这类大模型评测,离小说的「真实理解」场景,「真实写作」场景,差距也是非常非常大的。
而国产模型在这些简单的评测里的表现呢?目前来说,成绩也都挺惨的,那么实际的表现就更加可想而知了。\
所以,真正的小说理解能力是什么样的?能评测出来吗?
如果不看这些相对小众的指标,我们再深一层,去考验一些真实的问题。我举几个例子,都是写网文、看网文的人对一本书可能会提出的实际问题。
举例1:小说里,两个角色的关系到底是【真兄弟】还是【塑料兄弟】?
这个问题看起来简单,实际上难得要命。核心困难在于:证据是弥散的、矛盾的、需要加权的。
比方说,一部长篇网文里,两个角色可能有 200 次互动。其中 70% 是互怼、嘲讽、拆台(塑料兄弟证据),30% 是关键时刻的无条件支持、生死相托(真兄弟证据)。要得出「表面上互怼但底色是生死之交」这种判断,需要什么?(假设文中没有借某个角色或者旁白直接给出结论,大模型不能直接搜到结论来偷懒)
首先你得【遍历式感知】,你需要接触到足够多的互动场景,而不是定位到某一个片段就下结论。其次你得做权重判断,「在生死关头的一次出手」和「日常中的十次斗嘴」,哪个更能定义俩人的感情?这是个价值判断,没有标准答案。最后你还得做总结性的整合,真实的关系是复杂的,不可能用单一现象就概括。
现有的 benchmark 都预设了唯一正确答案。但「真兄弟还是塑料兄弟」本身就不是一个有唯一解的问题。没有 所谓的客观基准,就没有自动打分的基础,benchmark 就很难建一个标准。
举例2:这本武侠小说里,主角的武学体系到底是个什么情况?
比方说,张无忌、郭靖的武学是东一榔头西一棒子,博百家之长,我们假如说是一个新读者,想知道主角的武学体系究竟是什么样的,问大模型,大模型能回答吗?
你如果让大模型用大海捞针,直接列举它们学过哪些武功,是很简单的。大模型只需要做近似于搜索罗列的事情就好。
但是如果你问,俩人的武学体系是什么个路数?什么结构?和其他的武林高手的体系相比有什么特点?这种问题,大模型就抓瞎了。
尤其是,假如小说里没有一个角色锐评过主角的武学体系,大模型只能通过很多个事实来综合总结,不能引用他人的发言来偷懒作弊的时候,就更难了。
这种问题的核心困难在哪里呢?
在于,需要跨文本的结构化重建。提问者要求模型做的事情,实际上是一种逆向工程,从文本中抽取出一个作者可能没有明说过的体系。
那些玄幻、修真小说,修炼体系的信息可能是这样分布的:第 30 章提到主角修炼了某个基础功法,第 120 章通过战斗描写暗示了功法的运作原理,第 200 章一个配角的评论揭示了这个体系在世界观中的层级位置,第 350 章主角突破时才点明了几个阶段之间的关系。
模型需要做的不是找到描述修炼体系的那一段(很可能根本不存在这样一段),而是从数十个散布的碎片中,重构出一张架构图。
AI不仅面临着一个可能没有唯一答案的问题,更面临「到底什么算完整」的问题。
比如一个大模型提取了 5 个境界,另一个大模型提取了 8 个境界并说明了彼此的递进关系,后者显然更好,但怎么量化【更好】的标准呢?这时候,就需要领域专家的主观评分了。而一般自动化的打分很难实现。
关键是,很多评测benchmark就是基于相对客观的自动化打分才实现的,引入专家,就有作弊、无法统一标准的可能性了。
举例3:这本小说主线剧情的关键转折点有哪些?
再来一个这种困难问题吧。
上边这个问题的核心困难在于:「关键转折点」本身就是一个需要定义的概念。
「关键转折点」不是一个客观事实,而是一个叙事结构层面的判断。
它要求模型理解:因果密度(某个事件导致了多少后续连锁反应?导致越多,越可能是关键节点)、不可逆性(这个事件之后,故事是否发生了不可挽回的转向?)、叙事功能(这个事件在起承转合中扮演什么角色?是转折还是铺垫的释放?)、主观阈值(多大的变化才算转折?主角一次安静的决心转变算不算?还是必须有戏剧化的大冲突?)。
这里的困难不仅仅是信息分散,而是任务本身的定义模糊。
如今的很多榜单、 benchmark 没法评判这种场景,因为这种属于开放式任务,而一般的benchmark都是封闭式的。
例子4:这本书,女配角A出场了多少次?(她不是每次都用本名)
这表面上它看起来像一个可以有确定答案的事实性问题(出场 N 次),但实际操作起来却是噩梦级别的。核心困难在于之前说过的,涉及一个所谓「coreference resolution共指消解」的概念。
女配可能被称为【她】、【那个女子】、【师姐】、【赵家的大小姐】、【那个穿青衫的少女】——这些指称需要跨上下文才能确定指的是同一个人。然后【出场】怎么定义?被提到名字算出场吗?还是必须有行为描写?在别人的回忆中出现算吗?在长篇小说的规模下(可能几百万字),这种共指消解的链条可能有上百个环节。
关键很有意思的是,MRCR 的名字里就有【coreference resolution】(共指消解)这个词儿。我寻思,你名字里都有这个项目了,怎么反而还测不好呢?
于是我问了AI,AI说这个测试测的其实是一个极度简化版本的共指消解,是说在合成文本中,有明确标记的、可以用字符串匹配验证的共指。
而真实小说中的共指消解,是依赖对语境、人物关系、叙事视角的深度理解,AI说,真正的共指消解比评测里测的那个困难太多了,是自然语言中最困难的问题之一!
好吧我姑且信了。
所以说明什么呢?
总结
这四个很难解决的例子,可以归结为两个底层的原因。
第一,涉及小说的标准,存在评分困难的问题。现有 benchmark 的生命线是自动化评分,靠字符串匹配、事实核验、多选正确率。上面这些任务,要么没有唯一答案,要么答案的质量无法用简单规则衡量。没有可自动化的评分标准,benchmark 就建立不起来。
第二是规模问题。即使理论上可以用人类专家来评判(比如请一位深度读过这部小说的评论家来打分),这种标注的成本和时间也使得大规模 benchmark 不可行。而 benchmark 的意义恰恰在于可大规模、可复现地运行。
也就是说目前那些所谓的上下文评测benchmark,都是适合衡量「检索+局部推理」范畴的能力,对「全局涌现+综合判断」类的能力几乎无解。
为什么这种测试就做不了呢?
原因很简单:太难了。
我们人类看小说的阅读理解能力,对于大模型来说还是太难了,可能比写代码难多了。
目前几乎没有什么真实的测试集能反映这种深层理解小说的能力。
想一想,当人真正阅读一部长篇小说时,认知过程和大海捞针是完全不同的。
比如说主题的浮现。
你看完一个热血战斗番或者青春小说,感受到的是主角从弱小到强大的成长、兄弟情义的可贵,不是任何一个段落能直接给出的。它是跨越全书、逐渐在心智里堆积起来的「感觉」,评测集可不会测试这种「涌现性」的概括。
再比如隐含因果与动机推理。
当一个角色在第 300 章做出一个看似突兀的决定,而你理解这个决定的根源在第 50 章的一次对话、第 120 章的一个细节、以及第 280 章的一个暗示。这种跨文本因果链的推理远超找到第 N 根针的范畴。MRCR 的 needle(针)之间是独立的,没有因果关联。
还有情感弧线与叙事节奏。
你感受到主角从傲慢到谦虚的转变,不是因为你找到了某个旁白句子写着「他终于是变谦虚了」,而是通过数百个微小的行为变化、语气变化、选择变化累积感知的——哦,原来我们的主角不知不觉间竟然成长了这么多!
这种渐变式语义追踪,要怎么做呢?
大模型很难做到,而就算能做到了,评测也很难测到。
更不用说对于这部小说的结局是GE还是BE这样的很微妙的争议性问题,不同读者可能有完全不同的解读,这种超越文本的理解更没法搞了。
那么 MRCR 这种大模型评测的高分究竟能说明什么?
对于一个模型的理解能力,MRCR或者广义的大海捞针、注意力类型的测试,只能代表一个必要但远远不充分的前提条件。
就是说,大模型们,你们先把这个最最基本的测试做好吧,连这个都做不好,幼儿园都比不了业,更别提上大学了。
如果一个模型连 MRCR 8-needle 都做不好,就是说连在长文本中精确定位 8 个特定片段都做不到,那它几乎不可能完成复杂的长篇叙事理解。
但反过来是不成立的:就算拿了 MRCR 满分的模型,也完全不代表它就能真正读懂一部长篇小说。这就像一个人拥有过目不忘的记忆力,但这不等于他具备文学鉴赏力。
而之前那个更高标准的 Fiction.LiveBench,就像我说的,当它把Gemini 3 pro的长文注意力测得那么好的时候,你也就知道它根本无法反应真实的上下文注意力/理解了。
总之,我们目前能非常精确地测量模型的图书馆管理员能力(MRCR)和初级读书报告能力(Fiction.LiveBench)。
但对于【书评人】、【作者】的能力,现在这个世界上几乎没有可靠的量化手段。
国产模型的真实表现如何?
说到这里,不得不提一个很扎心的事实:很多国产模型甚至还没有官方公开 MRCR-V2 的测试数据。
根据我前两天在Grok做的多次搜索,公开的 leaderboard(比如 llm-stats.com 的 MRCR v2 / MRCR v2 (8-needle))目前只有少数国外模型,Claude Opus 4.6 在 8-needle 上最高能到 0.93 或者 76% @1M, Gemini 系列次之。GLM-5、MiniMax 2.5 都没有。
而在已经公布的数据中,比如普通的 MRCR 测试,情况也不乐观。GLM-5(200K 上下文)在 64K 位置只有 36.53%,128K 位置 35.39%。在第三方对比站点的 OpenAI MRCR v2 8-needle 分段测试中,4K-8K 能到 72%,但 32K-128K 就掉到 54.4%,128K-512K 继续掉到 42.8%,256K-1M 更是逐步衰减到 35.6% 左右。
MiniMax M1/M2.1(M2.5 还没有公开数据)在 OpenAI-MRCR 128K 能到 73~76%,1M 能到 56~58.6%,但 M2.1 在 128K 8-needle pointwise 只有 13.8%(虽然衰减曲线相对平缓)。
DeepSeek V4 的早期测试版(就网页上那个)目前没有任何 MRCR / OpenAI-MRCR 的具体分数,只宣称 1M Needle-in-Haystack(通用 NIAH,不是 MRCR)能到 97%+。它的前代 DeepSeek-V3.2 在 2-needle 128K 只有 54.4% 左右。
Kimi的数据相对是比较透明的,对于MRCRv2我也查到了一个第三方测的,其实是还不错的数据
4K-8K:61.9%
32K-128K:45.1%
128K-512K:34.9%
256K-1M / 512K-1M:24.6% / 23.1%
但实际上你们也能看到,这个数据,明显对于百万级上下文是不可用的,如果要按「真实理解」标准,那就更没戏了。
很多我们常用的国产模型在 100K 之内就已经出现断崖式下跌,得分只有 10% 到 40%,表现非常低迷。
当一个模型在 200K 以内能拿到 90%,但在 500K-700K 掉到 30-40% 时,它告诉你的是什么?模型对那个距离范围内的文本,注意力分辨率已经严重下降了,没法信任了。
比方说我就经常在小红书上看到用户吐槽说智谱的GLM-5在ClaudeCode的200k窗口里临近八九成就会开始胡言乱语或者复读。
这才200K,而GLM-5已经是国产模型目前的翘楚了。
这么说吧,就连我们刚才论证的「对于小说阅读理解最最基本的上下文注意力测试」,常用模型能力都这么差。
可想而知,如果把上下文扩展到 100 万,并且我们真的发明出来一个接近真实理解能力、难度更高的 Benchmark,这些模型去考试,它们的分数会惨到什么程度?
应该是惨到不敢发成绩的。
即使是像我们给予厚望的 DeepSeek V4 这样的模型,在某些网上流传的早期测试版本中也反映出,在 200K 左右的跨度下就已经出现了不乐观的结果。而我自己和群友实测网页版灰度的那个测试版本,在长篇小说的章节概括中 ,它虽然可以「貌似准确」地把各个阶段的章节剧情总结出来,但里面错漏颇多,该出现的幻觉都会出现,并没有什么奇迹发生。
而且大模型这个长文的「分辨率下降」在实际应用中的表现,不是线性的下跌,体验更有可能是一超出200K就断崖式暴跌,变得完全没法用了。关于这点,经常编程的朋友们应该有所体会。
实际上,我觉得无论是对话写作还是对话式问答,目前64k,最多不超过100k之内的范围,才是一般大模型最舒适,有智力的区间。说200k上下文都有点过于宽松了。
评测成绩高,不代表能做好长篇小说的概括
在这里,再说一个我的作者朋友们可能会关系的实际AI使用场景——小说的分卷概括。
我发现,在很多小说概括测试中,模型对长小说的概括能力也非常糟糕,存在严重的幻觉。这里面的原理是——长文概括和大海捞针测试是完全不同的工作。 MRCR 8-needle 的注意力模式是【聚光灯】式的。
在一百万 token 的文本中,模型只需要关注 8 个特定位置,剩下 99.99% 的文本可以全忽略,只要能精确命中那 8 个点就行。
逐章概括的注意力模式是【泛光灯】式的。
模型需要对每一段文本都有足够的感知:不能跳过任何一章,不能遗漏任何一个关键情节。这是一种均匀覆盖的注意力需求,就像你要把整个房间都照亮,不能有任何死角。这两种模式对模型的要求截然不同。 所以,从某种角度来说,全文概括比 MRCR 更容易。因为概括是一种有损压缩,而 MRCR 要求的是无损提取。
当你要求模型概括某一章的剧情时,它不需要逐字记住那一章的内容,只需要捕捉到这一章发生了什么大事,有这种大致的语义轮廓就够了。即使它对某些细节记忆模糊,它仍然可能产出一个合理的概括。
所以,一个模型在 500K 位置的 MRCR 得分降到 40%,不代表它对那个位置的文本完全看不见,它可能只是看得模糊了,无法精确还原,但仍然能捕捉到大意。 但是另一些方面来说,全文概括又比 MRCR 更难。因为容错率的计算方式不同。
大海捞针对于对错,对错判断是很明确,但是逐章逐卷概括小说,要求你在每一个位置都保持足够的注意。假设一部小说有 300 章,那你有 300 个必须不低于某个质量下限的节点。如果模型在中部的 100 章里注意力严重衰减,你就会得到一大段质量很差的概括。
然后,会发生什么事呢?
因为已经几乎没法好好概括了,模型就会开始编造,会开始自圆其说。一旦发生这种事,这对于小说概括拆书之类的工作来说就完蛋了。因为这比单纯的概括不出来可恶太多,很可能误导用户的工作。
The end?
最后我要讲的其实很简单,目前来说,甚至可以说在这一年两年内,「超长上下文窗口」这个概念,对于小说的拆解和写作来说基本都是没什么意义的。
因为上下文窗口长度不等于真实理解能力。
要真正解决小说拆解和写作问题,我们需要的不是更长的上下文窗口,而是更智能的Agent机制、更精细的工程设计、以及对理解这个概念本身的拆解。
简单的理解归简单的模型和流程,复杂的归复杂的工程。
就好比说我给自己做的拆书claude skills就是用了分部概括,Agent不断循环递归式理解,主动去原文里多次阅读找答案的方式,这是一种笨办法,也是目前唯一的好方法。
那,未来有没有大模型技术跃进的可能性?前阵子DeepSeek的论文,不是提出了「内置记忆」之类的概念和很多优化技术吗?Kimi的论文,不是被很多大佬夸赞吗?
我不是大模型技术专业的,没法自己下结论,只是在做了很多AI的资料调研之后,感觉那些提示更多侧重于提升过去我们所说的大模型的上下文能力(比如MRCR),可能能提升防止概念混淆的能力和局部的一些概念联系、理解能力。
但是并没有直接的证据证明,能对我说的那些对于文本的复杂理解能力哟改善。
比方说从之前放出来的疑似DeepseekV4lite的测试模型的能力来看,优化的确是有,但在长文的理解上,并没带来什么本质的变化。 所以改进是有希望的,但是个人以为,短期内看,有质变的希望不大。
不得不说,咱们文科相对于Coding和理科,对大模型的要求还是太高了一些。
但是,这些大模型卷上下文、卷benchmark,好处也是有的。
比如提升上下文窗口和模型注意力,最大的获益者是Agent工作流,可以让那些skill、工作流、AI工具,要做一些超长文的理解的时候效能更高、速度更快、更省钱,过去可能要花费一百块才能做的任务,以后五十块,十块就能做了,这也是一种进步。
总之只要有优化,就是好事。