GPT写作学习:让o3-Pro教你AI写作中「高熵定律」
前两天,我看到了一篇x上的推文by汉松@yonah_x,讲的是一项AI研究,看起来很激动人心,但是因为写的有些玄乎,我作为一个文科生,属实看得一知半解。
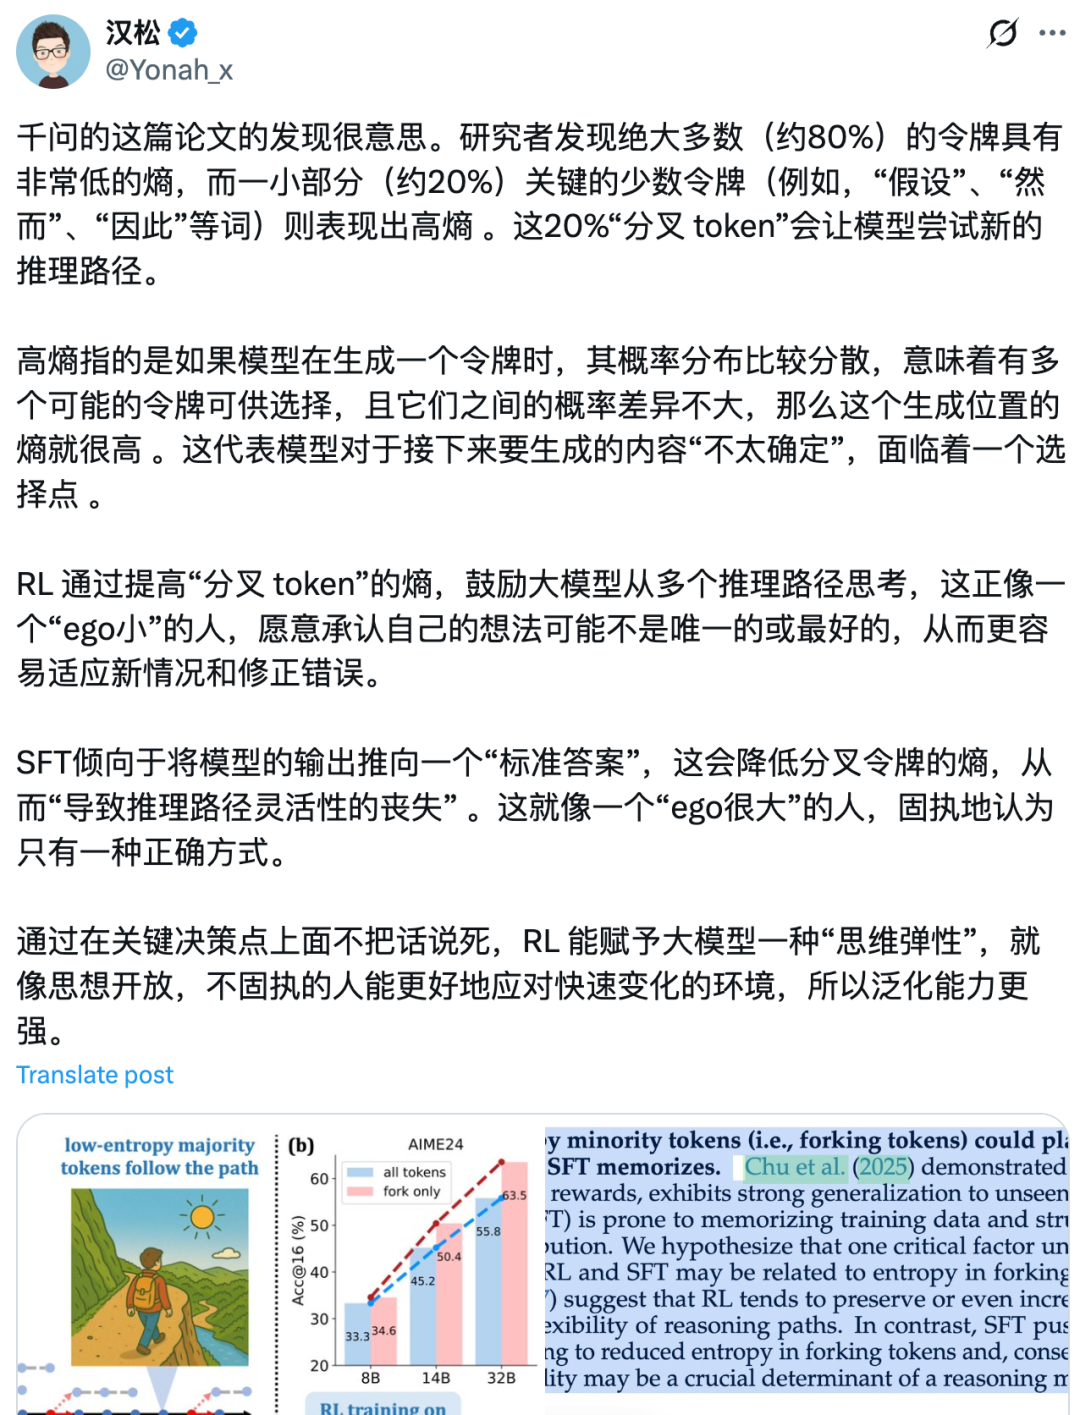
正好,这不是o3-pro这个超级会思考的大模型推出了吗? 我就让他帮我整理一下。
我先是复制了这个推文,然后这么说
以上是我给你发送的一篇推文,推文介绍了一项研究,配图也是推主的解释。我希望你完整分析并评估此项研究,并充分理解推主想要表达的意思,然后将这项发现用清晰易懂、但是不损失信息量的方式解释给我听(不要为了简单而做了不恰当的比喻或者有不恰当的删减)。解释完之后,告诉我几种可能的思路,如何利用这个发现优化提示词写作.
最近,我和ChatGPT就深度问题的提问方式都是这样的,我并不遵循什么提示词模板,而是我自己的思路具现化。
首先是【背景介绍】。
随后是【任务指定】。
再然后,是【提出一些需要避免的常见误区】。
比如我过去曾经发现,有时候AI会为了说的太大白话而油腔滑调,将一些知识过度肤浅化来讲了,因此这一次我着重强调了不要那样做。
最后,让AI告诉我,【针对这个问题,我可以获得什么新知】、【它可以怎样帮助我的生活或者工作】?
就像我之前的文章所说,AI知识必须指导我们的行动才有价值,因此我的每一次提问都要关注这个问题——知道了这件事,我能怎样改变自己?
因为我现在的本质工作就是研究AI写作,因此我自然提出了「利用这个发现优化提示词写作」的要求。
需要注意的是,这一连串问题其实包含的思考量极大,对AI的要求也很高。
如果是对以前的AI,比如Claude-3.5-sonnet或者GPT-4o,o3,我可能不会一口气提出这么多的要求。而是会分开问。因为分开问得到的回答更详细深入。
但是对于o3-pro,这个本来就以知识丰富,思考深入著称的AI,我的要求就自然要提高了。我也希望看看他能做到什么地步。
然后,果然,o3-pro就这个问题进行了一番研讨与思考,花了十分钟,给了我如下图的回答:
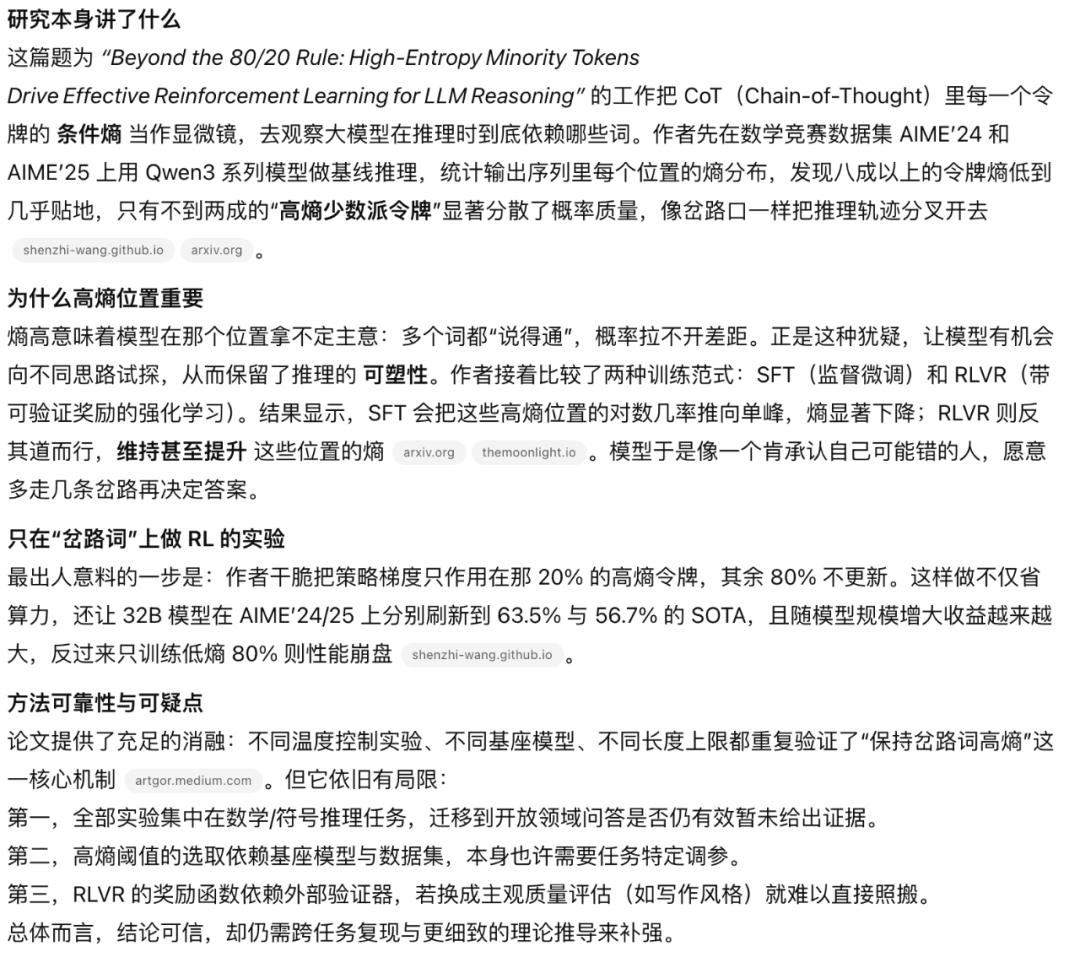
我们可以看到,首先o3-pro是真的主动去搜索了原论文并且进行了原文分析。这一点是可以使用各种工具的最新旗舰AI具有的优秀品质,例如o3和Gemini-2.5-pro都可做到。
然后,o3-pro为我做了一番深入浅出的解释,这个论文是如何实验的,得到了什么样的结果,并且把最容易理解的关键词为我标出了,让我这个虽然完全不懂大模型训练的人,也能明白关键问题是什么。
他还对论文的结论进行了可靠性的评估,没有全盘接受论文的观点。看起来很不错吧?
下边更有意思。虽然论文讲完了,但是推主的观点如何,是否准确中肯?这个知识对我又有什么意义呢?
o3-pro是这么说的:
推主类比的含义
推主把 RLVR 比作 “ego 小、愿意承认自己可能错的人”,把 SFT 比作 “ego 很大的人”。类比的核心在于 熵即不确定性:人若承认不确定,就会在关键节点保留多条选项;模型亦然。 这个比喻抓住了现象的社会直觉,却略简化了 RL 奖励在搜索空间里“剪枝—放松—再收束”的动态过程。但总体并未误导。
如何把发现用在提示词写作
首先,在你想让模型多角度思考的场景,主动插入能制造岔路的词语,例如 “假设”、“然而”、“另一种可能是”。这些词天然在抽象层面打开分支,提升局部熵。
接着,你可以显式要求模型 “先列出所有合理思路,再逐一评估”。这种指令让高熵位置提前到推理链前端,RL 不在场时也能增加路径分叉。
第三,若使用 API,可在关键语句之间分段调用:对 “列出思路” 这段设高 temperature,对 “给出结论” 这段设低 temperature。手动模仿论文里“只在高熵位置放松分布”的做法。
最后,当任务需要稳定答案(例如生成规范格式代码)时,反其道而行: 避免使用“也许”“假如”之类岔路词,把问题描述得具体且唯一,等于人为降低高熵位置的出现频率,让输出更确定。
上述几步不需额外训练,就能部分复现论文的启示:在需要创造力时给模型制造岔路,在需要确定性时堵住岔路。
o3-pro这么给我一讲, 可以说是醍醐灌顶了。
它首先分析了推主这么一大堆论述究竟是怎么个思路,推主的比喻是否有不恰当之处,然后告诉了我在写作中,该如何更好地编写提示词:什么时候应该故意去「增加不确定性」,什么时候应该少用不确定的词语。
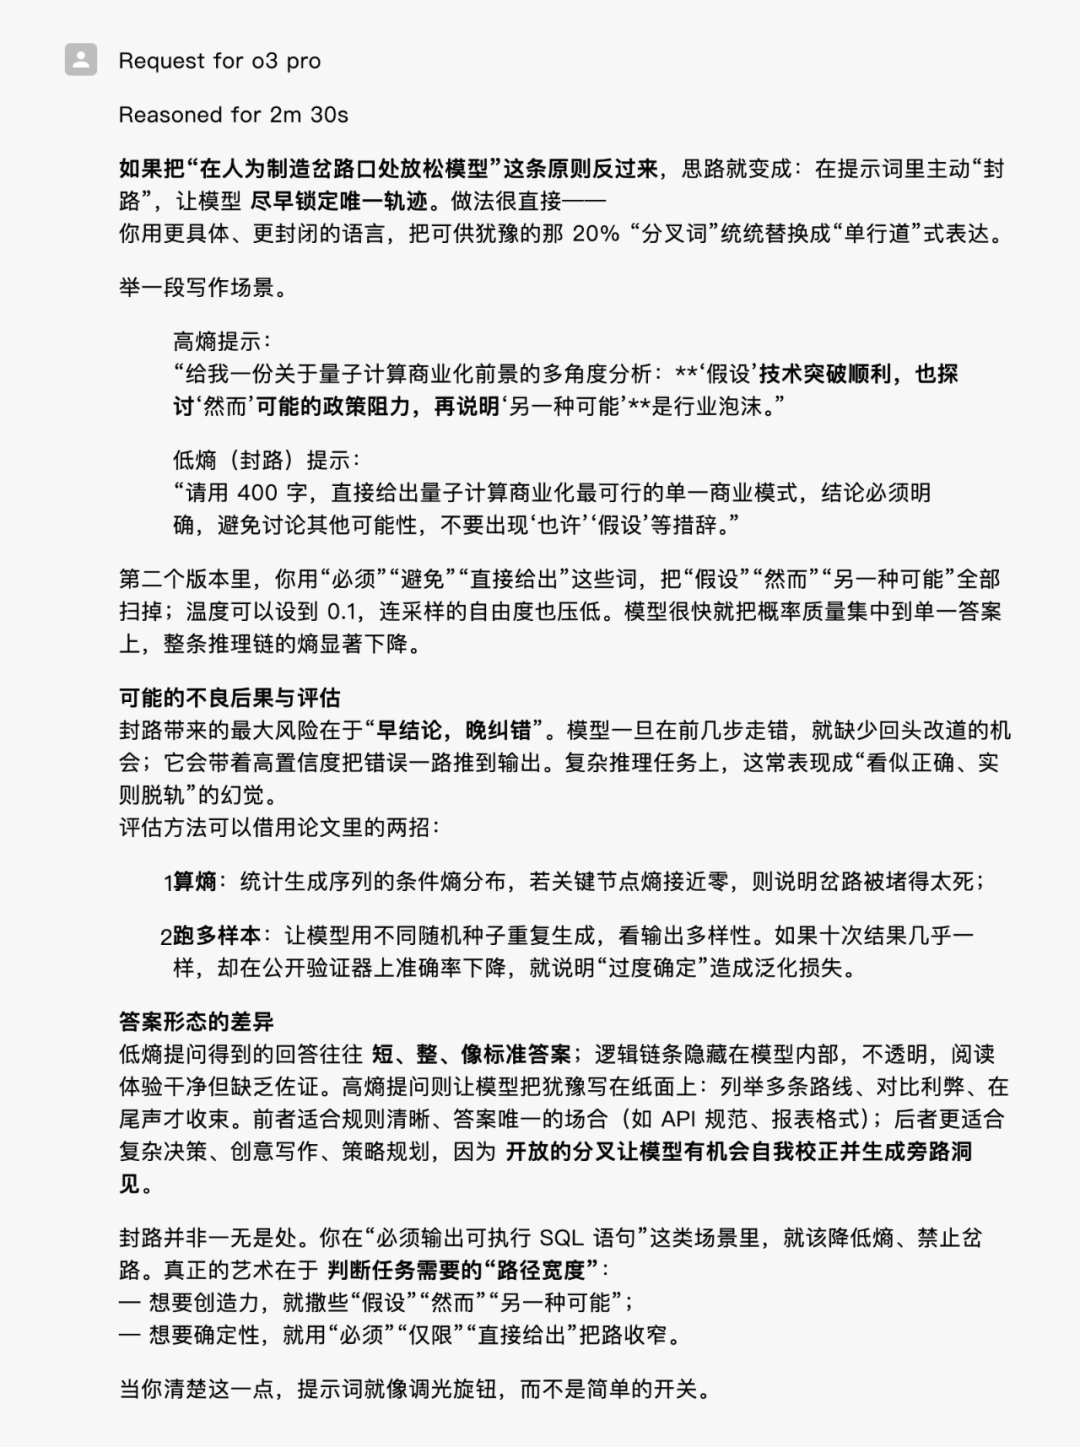
到这一步,我已经很满意,但是还是按照我的习惯追问了一句:如果不这样,反向思维,会变成什么样?
这一次,o3-pro给我的答案,比起刚才来说更加深入,我们不仅知道了「低熵」的情况下大模型会变得缺乏创意和洞见,还知道了这种封死大模型思路的方式往往是很多大模型长对话下越来越「愚蠢」的可能原因。
最后,终于到这次交流的重头戏了。我希望o3-pro根据刚才我们的讨论,为我们制作一份提示词写作的指南。
接下来,我会原封不动把这份指南复制粘贴在下边,大家可以参考学习。
写好一条提示词,就像给模型铺一条路。高熵视角提醒我们:在路口多放几盏绿灯,模型才有机会试错、改正、探索。下面这份通用指南围绕写作、调研、思考三个常见场景,说明如何利用“局部高熵”唤醒模型的推理弹性,同时避免走向漫无边际。
首先要意识到,两个动作决定了熵的走向:一是你用什么词,二是你如何限定任务边界。词汇层面,带有“假设”“然而”“另一种可能”意味的转折、开放连接词,天然提升局部熵;边界层面,加入“先列举,再评估,最后收束”这样的阶段指令,允许模型在中前段分叉,到末尾归并。
当你让 AI 写作,可以先抛出一句“请先列举三条完全不同的切入角度,再从中挑一条深入展开”,你就把高熵位置前置,让模型在列举阶段自由散射;紧接着补一句“最终输出只能保留一个视角,一千字以内”,用低熵结尾收束。如此既保创意,又保成稿。
做调研时,可以把问题拆成“广度—深度”双层。先问“罗列所有主要流派及其代表文献”,再追问“针对最受争议的那一派,提炼核心论证并给出反驳证据”。第一问制造高熵,第二问设定聚焦。模型会在第一步揭示可能遗漏的信息源,在第二步呈现凝练分析。
面对思考性、创造性提问,你可以直接植入多路径要求:“请同时用经济学、心理学、系统动力学三个视角分析……每个视角先举正面案例,再举反面案例,最后比较异同,提出综合方案。”这里有显式的多视角、多案例、多结论,每一步都是高熵节点。最后让模型“用一段不超过两百字的摘要收尾”,再次降熵,保证输出可读。
风险与调节同样重要。高熵带来新意,也带来跑偏概率。你可以在温度参数上做分段:生成思路时温度 0.8,输出最终结论时温度 0.2。或者跑三到五个并行回答,用人工挑选、交叉验证;如果发现答案差距巨大且缺乏共同事实,就说明熵过高,需要收紧提示词或补充客观约束。
记住“高熵≠长篇大论”。真正有效的高熵来自关键节点的多选项,而不是流水账式冗言。控制总字数、指定输出结构,都能在保证信息密度的前提下维持多样性。
最后,遇到代码生成、精确定义等不容分歧的任务,主动删去一切岔路词,使用“必须”“仅限”“不要出现”之类指令,让模型一路低熵到底。这样,你手中的提示词就像变焦镜头:想要创意时放宽焦距,想要确定时收紧光圈。
不知道大家的感觉怎样?
船板我的感觉是,文风是典型的考究GPT风格,而论述的深入浅出,也是o3系列模型里的一个新的高峰。
特别是文章结尾这个用相机镜头调光圈来比喻提示词写作中的高低熵,简直是太对我的胃口了!
因为我会经常摄影,也玩镜头,几乎立刻就领会了这个比喻的妙处。
——光圈放大就会造成景深变浅,很多地方是模糊的,代表具有更多的可能性;光圈缩小,画面中一切物相机都会清晰无比,毫无差错,也没有了模糊的余地,这不就是文章讨论的吗?简直太形象了!
不知道是不是GPT之前和我聊天的时候记得这一点,所以才会这么写呢?
尾声
总之,船板今天的分享就到这里。
最后说几句感叹吧。
自从o1和deepseek-R1出现,深度思考模型可以给一般人的学习、成长带来的变量,简直就像是工业革命之于人类历史一样具有颠覆性。
最近半年,我不计成本,购买了很多最好的AI产品,而这半年,也成为了我多年里好奇心最为旺盛、学习欲望最强的时期。
前几天Sam Altman说,温和的奇点已经来临。许多人深有同感,我也是其中之一。
因为我的日常生活、工作、写作创作,乃至于人生成长,都被AI深深地激励、推动了。
我建议看到文章的你们,如果你们手头能够深度思考的模型,看到任何奇怪的、复杂高深的、有趣的线索,都可以扔给AI让他来分析、阐释一番,再和它随便闲聊,看看能不能对自己有什么帮助。你们一定会遇到很多惊喜的。
说起来,Google的深度思考模型Gemini-2.5-pro-deepthink马上也要推出了。到时候,又会有很多精彩的事情发生吧。
(所有文章和文章中分享的和AI的长对话,我都会更新在我建立的IMA知识库中,欢迎订阅知识库、下载文件,以及和我链接,我是研究写作理论、写故事、琢磨AI写作的忒修斯的船板)